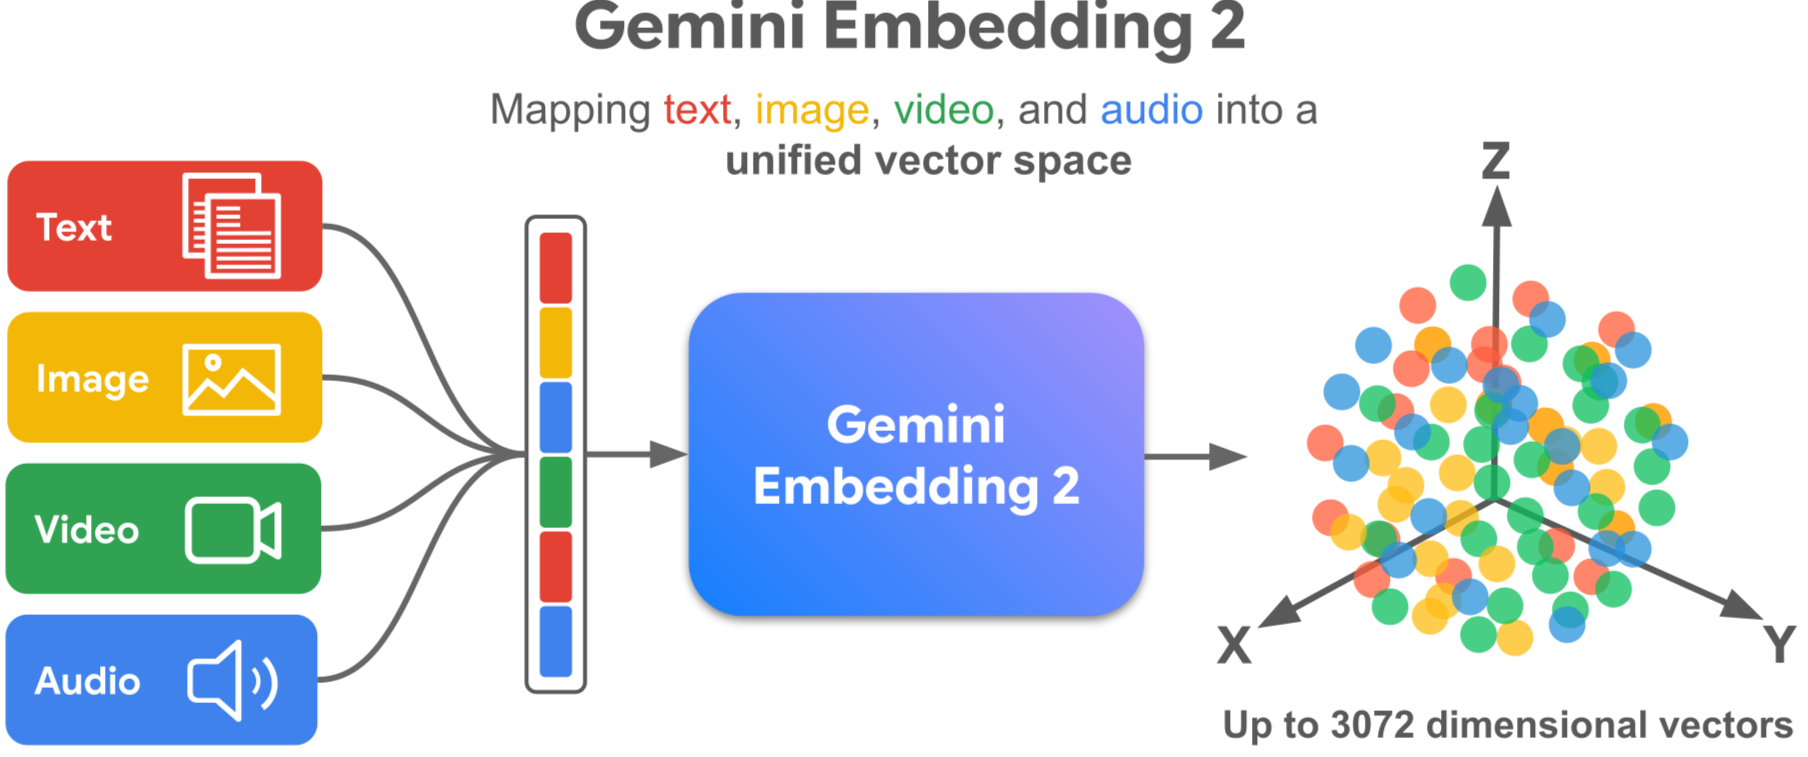
EmbeddingGemma 2 คือโมเดล embedding แบบ multimodal ขนาด 740 ล้านพารามิเตอร์ สำหรับประมวลผลบนอุปกรณ์ รองรับข้อความ โค้ด ภาพ วิดีโอ และเสียงใน embedding space เดียวกัน จึงใช้ค้นหาคลิปจาก voice memo หรือค้นเสียงด้วยคำค้นแบบข้อความได้
โมเดลนี้ใช้ใบอนุญาต Apache 2.0 และทำงานด้านโค้ดดีขึ้น 9.92 จุดบน MTEB Code จาก 68.76 เป็น 78.68 เหมาะกับการทำ local codebase indexing, semantic code search และระบบ RAG ที่ทำงานออฟไลน์.
เวลาต้องหาคลิปวิดีโอจาก voice memo เรามักจำได้แค่สิ่งที่พูด แต่ไม่รู้ว่าคลิปนั้นอยู่ไฟล์ไหน ยิ่งมีไฟล์เสียงหลายชั่วโมง การค้นทีละไฟล์ก็ยิ่งเสียเวลา
โจทย์คือทำอย่างไรให้คำค้นข้อความพาเราไปเจอช่วงเสียงที่ต้องการได้ โดยไม่ต้องพึ่งการเชื่อมต่ออินเทอร์เน็ตนี่ล่ะ
EmbeddingGemma 2 อยู่ตรงไหนในกลุ่มเทคโนโลยีของ Google
EmbeddingGemma 2 คือการต่อยอดจาก EmbeddingGemma รุ่นแรกที่เน้น text embedding บนอุปกรณ์ โดยขยับไปจับ code, images, video และ audio ใน shared embedding space เดียวกัน จึงรองรับการค้นหาข้ามรูปแบบข้อมูลได้ในโมเดลเดียว
ตัวโมเดลสร้างบนสถาปัตยกรรม Gemma 4 และใช้เทคโนโลยีเดียวกับ Gemini Embedding models ส่วนใน Google AI Edge มันทำหน้าที่เป็นแกนสำหรับสร้าง embedding บนอุปกรณ์ ช่วยให้แอปทำ semantic search และ retrieval บน edge hardware ได้ แม้ทำงานออฟไลน์.
รุ่นแรกกับรุ่นใหม่ ต่างกันตรงไหน
รุ่นแรกเน้น text embeddings สำหรับจัดระเบียบ ค้นหา และเชื่อมโยงข้อมูลบนอุปกรณ์ ส่วน EmbeddingGemma 2 ขยายไปสู่ code, images, video และ audio ใน embedding space เดียวกัน พร้อมรองรับการค้นหาข้ามรูปแบบข้อมูล
| Factor | EmbeddingGemma | EmbeddingGemma 2 |
|---|---|---|
| ประเภทข้อมูล | ข้อความ | ข้อความ, code, images, video และ audio |
| ความสามารถแบบ multimodal | เน้น text embeddings | รองรับ multimodal ในโมเดลเดียว |
| จำนวนพารามิเตอร์ | ไม่ระบุในแหล่งข้อมูล | 740 ล้านพารามิเตอร์ |
| ประสิทธิภาพด้านโค้ด | ไม่ระบุในแหล่งข้อมูล | MTEB Code 78.68 |
| กรณีใช้งาน | ค้นหาและเชื่อมโยงข้อมูลข้อความ | ค้นหาโค้ด ค้นหาคลิปจากเสียง และค้นหาไฟล์มีเดียด้วยข้อความ |
เมื่อ embedding เดียวต้องเข้าใจทั้งข้อความ ภาพ เสียง และวิดีโอ
ลองนึกถึงคลังสื่อที่ค้นได้ด้วย “ความหมาย” แทนชื่อไฟล์ คุณใช้ข้อความหรือภาพค้นหารายการที่ใกล้เคียงกันได้ เหมาะกับการจัดการรูป วิดีโอ และเอกสารในเครื่อง
ถ้าต้องหาช่วงสำคัญในวิดีโอ ก็ใช้ข้อความหรือเสียงเป็นคำค้นได้ เช่น ค้นจาก voice memo เพื่อหา video clip ที่เกี่ยวข้อง โดยทั้งหมดทำงานผ่าน embedding space เดียวกัน
เมื่อจับคู่กับ Gemma 4 จะได้ local file retrieval และ contextual reasoning ใน pipeline เดียวกัน ส่วน MediaPipe Decision Task API เหมาะกับการทำระบบ classification, routing และ predictive capabilities แบบเรียลไทม์จากข้อมูลหลายรูปแบบ
สิ่งที่แหล่งข้อมูลยืนยันได้เมื่อเทียบกับทางเลือกอื่น
แหล่งข้อมูลไม่ได้เปิดเผยชื่อโมเดลคู่แข่ง จึงไม่ควรสร้างตารางเทียบรายชื่อเอง ตารางนี้เทียบเฉพาะจุดยืนที่บทความยืนยันได้
| Factor | EmbeddingGemma 2 | โมเดล specialist ที่ใหญ่กว่า |
|---|---|---|
| ขนาดโมเดล | 740 million parameters | มากกว่า EmbeddingGemma 2 มากกว่า 2 เท่า |
| คุณภาพต่อจำนวนพารามิเตอร์ | มาตรฐานใหม่ในกลุ่ม sub-1B | ไม่ได้ระบุรายละเอียด |
| รูปแบบข้อมูล | ข้อความ โค้ด ภาพ วิดีโอ และเสียงใน embedding space เดียวกัน | โมเดลเฉพาะทาง |
| การทำงานบนอุปกรณ์ | เหมาะกับ on-device inference และทำงานออฟไลน์ได้ | ไม่ได้ระบุในแหล่งข้อมูล |
จุดเด่นและข้อจำกัดจากข้อมูลที่มี
ข้อดี
- +รองรับข้อความ โค้ด ภาพ วิดีโอ และเสียงใน embedding space เดียวกัน
- +ประมวลผลบนอุปกรณ์และทำงานออฟไลน์ได้ ช่วยเรื่องความเป็นส่วนตัว
- +ใช้ Apache 2.0 และมี code performance ดีขึ้น
ข้อเสีย
- −ยังไม่ระบุราคาและความต้องการฮาร์ดแวร์ที่เจาะจง
- −ผลทดสอบทั้งหมดต้องดูเพิ่มจาก model card
- −รายละเอียดการรองรับอุปกรณ์แต่ละประเภทในแหล่งข้อมูลยังไม่ชัดเจน
ต้นทุนจริงของการนำโมเดลไปรันบนอุปกรณ์
EmbeddingGemma 2 มี 740 ล้านพารามิเตอร์ จึงเหมาะกับการทำ inference บนอุปกรณ์ แต่ก็ยังต้องเผื่อหน่วยความจำสำหรับ pipeline ที่ทำงานร่วมกับ Gemma 4 ด้วย จุดแข็งคือใช้ text tokenizer และ audio encoder ร่วมกัน ทำให้หน่วยความจำรวมของทั้งระบบลดลง
ต้นทุนไม่ได้มีแค่ตัวโมเดล แต่รวมถึงการทำ embedding ให้ข้อมูลหลายรูปแบบ และการต่อระบบค้นหาแบบข้ามสื่อ ส่วน inference และ fine-tuning มี guide ให้ศึกษา แต่อุปกรณ์และทรัพยากรที่ต้องใช้จริงยังต้องดูตามงาน
การประมวลผลบนเครื่องช่วยรักษาความเป็นส่วนตัว ลดความหน่วง และทำงานออฟไลน์ได้ แต่ผู้พัฒนาต้องรับภาระดูแล pipeline และหน่วยความจำเอง
เหมาะกับทีมที่ต้องการค้นหาและดึงข้อมูลแบบออฟไลน์
เหมาะกับนักพัฒนาระบบค้นหาบนอุปกรณ์ ทีมที่ทำ privacy-first RAG และงานจัดทำดัชนีโค้ดหรือ semantic code search รวมถึงแอปที่ต้องค้นหาสื่อข้ามรูปแบบ เช่น ใช้ข้อความค้นหาไฟล์เสียงหรือวิดีโอ
เหมาะกับ
- นักพัฒนาระบบค้นหาบนอุปกรณ์
- ทีมที่สร้าง privacy-first RAG และ semantic code search
- ทีมทำแอปค้นหาสื่อข้ามรูปแบบ
ลองชั่งน้ำหนักดู
- ผู้ที่ต้องการตรวจสอบ benchmark เต็มรูปแบบหรือการรองรับฮาร์ดแวร์เฉพาะ
ข้ามได้เลย
- ทีมที่ต้องรู้ต้นทุนเชิงพาณิชย์ก่อนใช้ — ควรศึกษาข้อมูลเพิ่มเติมจากแหล่งอื่น
ก้าวต่อไปคือการทดลองกับข้อมูลจริงของคุณ
EmbeddingGemma 2 น่าสนใจตรงที่รวมการค้นหาโค้ด เอกสาร ภาพ เสียง และวิดีโอไว้ใน embedding space เดียว โมเดลเดียวจึงเหมาะกับงานค้นหาข้อมูลข้ามรูปแบบบนอุปกรณ์ของคุณ
ลองเริ่มจาก Instant Media Search หรือ Video Moments Finder ใน Google AI Edge Gallery ก็ได้ ถ้าต้องการทำ pipeline ที่ค้นหาไฟล์ด้วย EmbeddingGemma 2 แล้วให้ Gemma 4 ช่วยทำความเข้าใจต่อ Google AI Edge Foresight เป็นอีกตัวอย่างที่น่าลองครับ