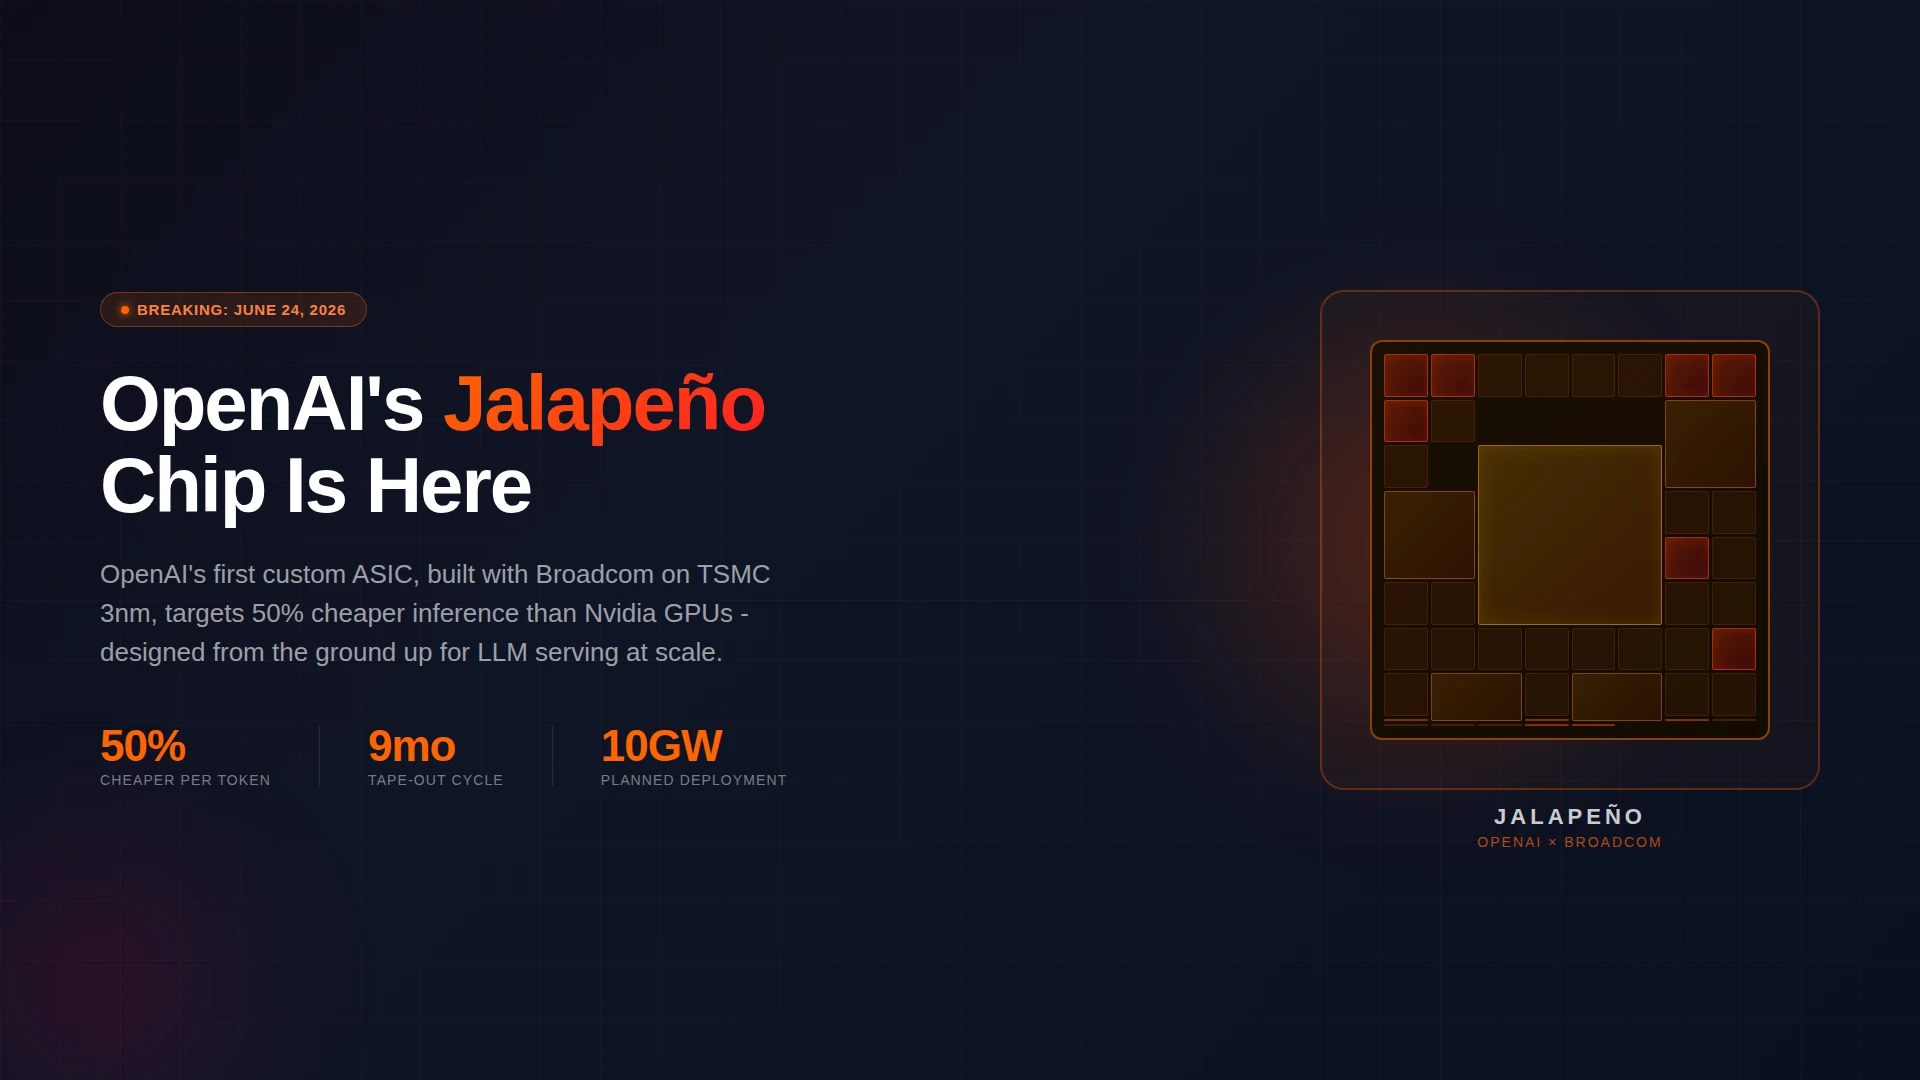
TL;DR: Jalapeño คือชิป ASIC สำหรับงาน inference ที่ OpenAI ออกแบบร่วมกับ Broadcom ตอนนี้ใช้รันงานภายในของ OpenAI เท่านั้น บริษัทเองก็บอกว่าจะ “มือเต็ม” กับ Jalapeño ไปอีกนาน ก่อนจะคิดเรื่องขยายสู่ตลาดภายนอก
Jalapeño คือชิป ASIC (application-specific integrated circuit) ตัวแรกที่ OpenAI ออกแบบเองสำหรับงาน inference หรือขั้นตอนที่โมเดลประมวลผลคำตอบให้ผู้ใช้ ต่างจาก GPU อเนกประสงค์อย่างของ Nvidia ตรงที่ Jalapeño ถูกปรับแต่งมาให้เหมาะกับรูปแบบงานของ OpenAI โดยเฉพาะ ตั้งแต่การจัดการหน่วยความจำไปจนถึงรูปแบบการประมวลผลที่โมเดลภาษาขนาดใหญ่ใช้จริง
Jalapeño คืออะไร และใครอยู่เบื้องหลัง
Jalapeño พัฒนาโดย OpenAI ร่วมกับ Broadcom ซึ่งรับหน้าที่ทั้งออกแบบร่วมและผลิตชิป ส่วน Celestica ดูแลงานประกอบบอร์ด แร็ก และระบบโดยรวมในดาต้าเซ็นเตอร์ ความร่วมมือนี้เป็นส่วนหนึ่งของดีลพัฒนาอุปกรณ์เร่งความเร็ว AI แบบกำหนดเองระดับ 10 กิกะวัตต์ที่ OpenAI และ Broadcom ประกาศร่วมกันเมื่อเดือนตุลาคม 2025
ทีมออกแบบนำโดย Richard Ho รองประธานฝ่ายฮาร์ดแวร์ของ OpenAI ซึ่งขึ้นเวทีงาน Hot Chips 2026 ร่วมกับ Ravi Narayanaswami และ Chris Leary เพื่อเปิดเผยรายละเอียดของชิปเป็นครั้งแรก
สเปกที่ OpenAI เปิดเผยในงาน Hot Chips 2026
ตามข้อมูลที่ OpenAI นำเสนอในงาน Hot Chips 2026 แต่ละชิป Jalapeño มาพร้อมหน่วยความจำ HBM4 ขนาด 216GB ความเร็ว 15.4TB/s ต่อชิป ใช้สถาปัตยกรรมแบบ NUMA ที่แบ่งออกเป็น 64 core/memory slice โดยแต่ละ slice จับคู่กับหน่วยความจำ HBM ของตัวเองเพื่อลดการเคลื่อนย้ายข้อมูลข้ามชิป กินไฟราว 700W ต่อตัว และให้กำลังประมวลผลสูงสุด 13.4 PFLOPS ที่ความละเอียด MXFP4
ด้านการเชื่อมต่อ ชิป 128 ตัวจะรวมกันเป็นกลุ่มย่อยที่สื่อสารกันด้วยเครือข่ายความหน่วงต่ำ ก่อนขยายเป็นกลุ่มใหญ่ระดับ 2,048 ชิปผ่านสวิตช์ Broadcom Tomahawk6 ในโครงสร้างเครือข่ายแบบ Clos สองชั้น
OpenAI อ้างว่า Jalapeño ให้ throughput ต่อกิโลวัตต์สูงกว่า Nvidia GB200 และ GB300 ราว 1.5-1.9 เท่า และมี latency ต่ำกว่า 1.7-3.6 เท่าในการทดสอบกับโมเดลอย่าง GPT-OSS 120B, DeepSeek R1 และ Kimi K2.5 ทั้งหมดนี้เป็นตัวเลขที่ OpenAI เปิดเผยเอง ยังไม่มีการทดสอบอิสระจากบุคคลที่สามมายืนยันซ้ำ
กระบวนการพัฒนาใช้เวลาประมาณ 9 เดือนจากแนวคิดสถาปัตยกรรมช่วงปลายปี 2024 ไปจนถึง tape-out ช่วงปลายปี 2025 และ OpenAI ระบุว่า ChatGPT เริ่มรันบนชิปนี้แล้วตั้งแต่ช่วงกลางปี 2026
ทำไม OpenAI ต้องควบคุมชิปของตัวเอง
ผู้ใช้ ChatGPT ไม่ได้สนใจว่าคำตอบมาจากชิปอะไร แต่รู้สึกได้ทันทีเมื่อระบบตอบช้าในช่วงที่มีคนใช้งานพร้อมกันจำนวนมาก ขณะเดียวกัน OpenAI ก็ต้องแบกรับต้นทุนการประมวลผลที่เพิ่มขึ้นตามจำนวนผู้ใช้ และต้องวางแผนงานตามกำลังการผลิตของผู้ผลิตชิปรายอื่นที่ไม่ได้ออกแบบมาเพื่องานของตัวเองโดยเฉพาะ
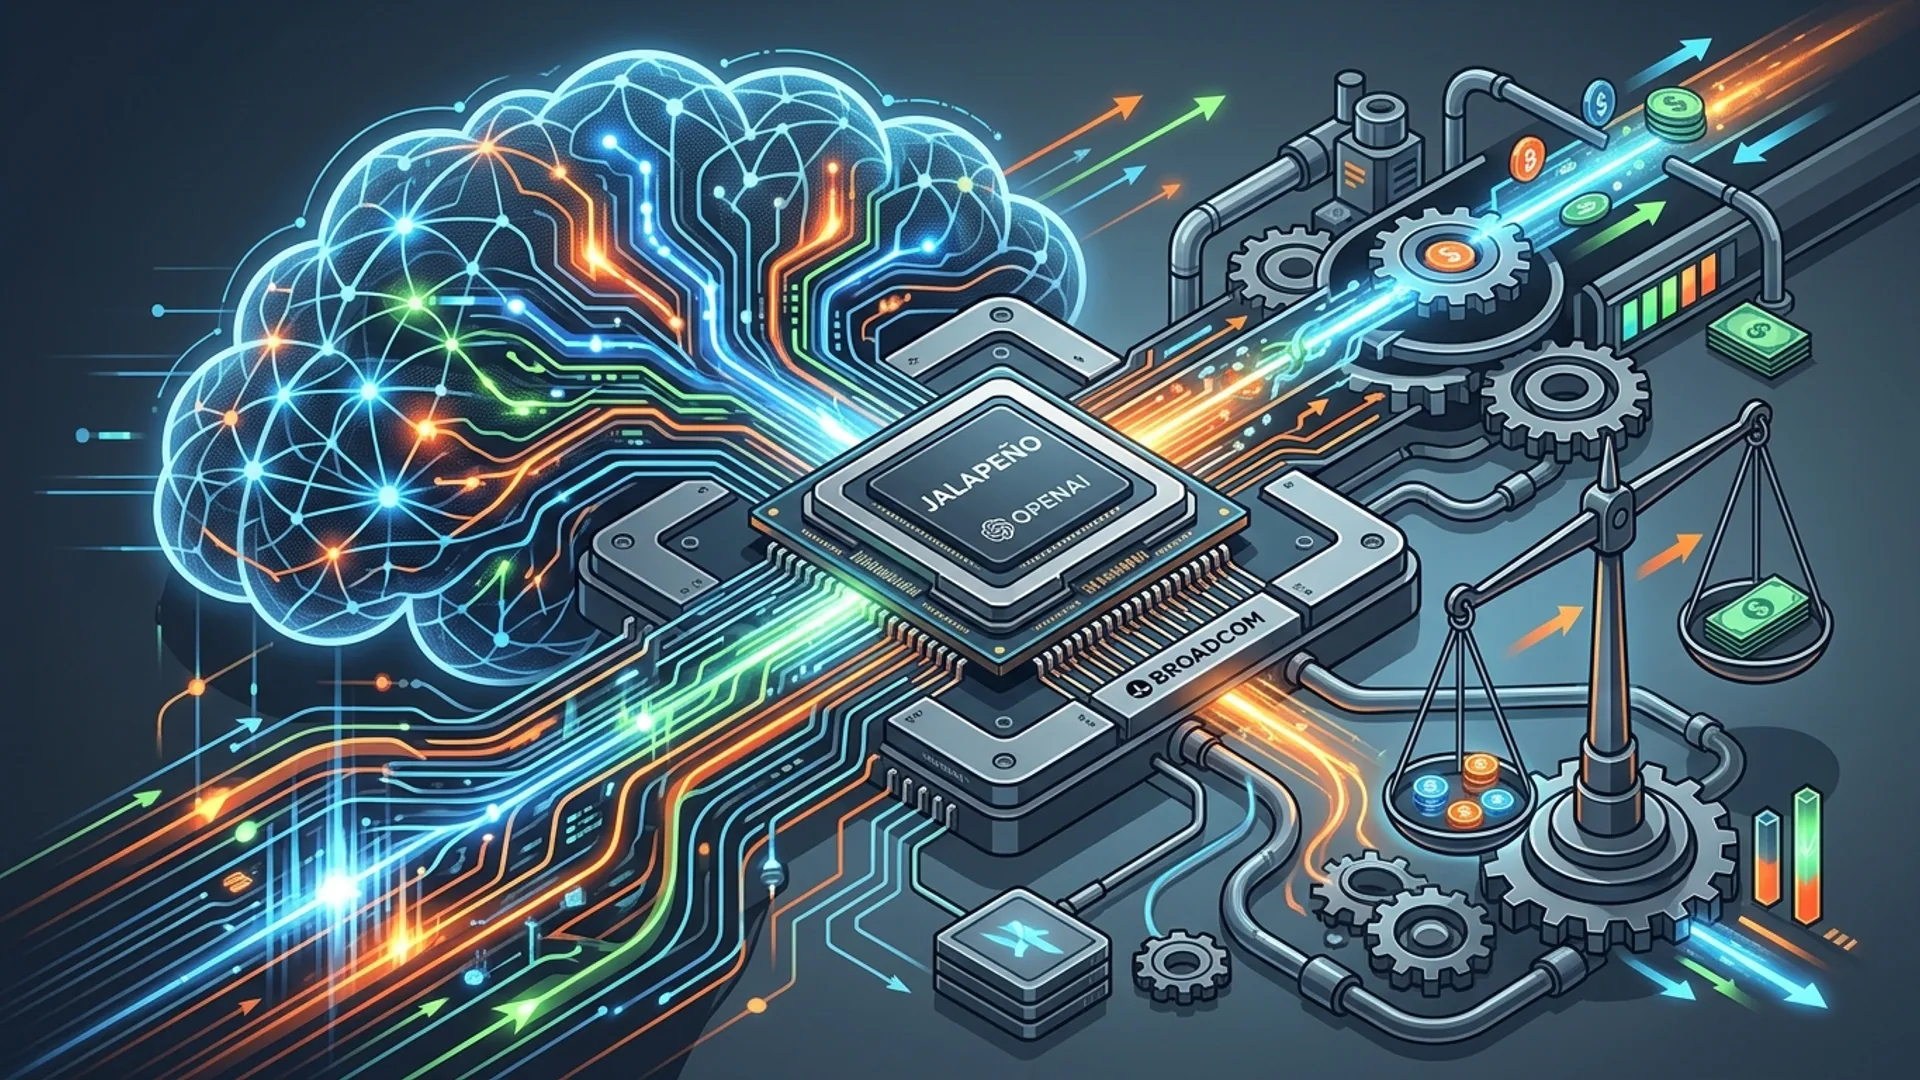
Jalapeño เปรียบเหมือนเครื่องยนต์ที่ออกแบบให้เข้ากับรถของตัวเองโดยเฉพาะ แทนที่จะเลือกใช้ชิ้นส่วนสำเร็จรูปที่ต้องรองรับรถหลายรุ่น การคุมทั้งฮาร์ดแวร์และซอฟต์แวร์เองจึงช่วยให้ OpenAI ปรับระบบให้ตรงกับรูปแบบงาน inference ของตัวเองได้มากขึ้น แลกกับความเสี่ยงและต้นทุนด้านการออกแบบและผลิตที่บริษัทต้องรับเอง
Jalapeño เทียบกับ GPU ที่ OpenAI ใช้งานอยู่ตอนนี้
| Factor | GPU ทั่วไป (เช่น Nvidia GB200/GB300) | Jalapeño |
|---|---|---|
| กำลังไฟต่อชิป/แร็ก | GB300 อยู่ที่ราว 1,400W ต่อชิป | 700W ต่อชิป |
| Throughput ต่อกิโลวัตต์ | ใช้เป็นเกณฑ์เทียบ | สูงกว่าราว 1.5-1.9 เท่า ตามที่ OpenAI ระบุ |
| Latency | ใช้เป็นเกณฑ์เทียบ | ต่ำกว่าราว 1.7-3.6 เท่า ตามที่ OpenAI ระบุ |
| การใช้งานจริง | วางขายกว้าง มีข้อมูลพิสูจน์แล้วจากผู้ใช้จำนวนมาก | รันงานภายในของ OpenAI เท่านั้นในตอนนี้ |
| ความเสี่ยงด้านการพัฒนา | ความเสี่ยงต่ำกว่า เพราะเป็นของสำเร็จรูป | OpenAI ต้องรับความเสี่ยงด้านออกแบบและผลิตเอง |
ตัวเลขด้าน throughput และ latency เป็นผลทดสอบที่ OpenAI นำเสนอเองในงาน Hot Chips 2026 ส่วนกำลังไฟของ Jalapeño (700W) และของ GB300 (ราว 1,400W) เป็นค่าที่ถูกอ้างอิงคู่กันในรายงานเดียวกัน ยังไม่มีตัวเลขต้นทุนต่อหน่วยหรือราคาผลิตที่เปิดเผยต่อสาธารณะ
ใช้ภายในจน “มือเต็ม” ไปอีกนาน ก่อนจะคิดเรื่องขยายตลาด
OpenAI ระบุตรง ๆ ว่าบริษัทจะ “มือเต็ม” กับ Jalapeño ไปอีกนาน นั่นหมายความว่ากำลังการผลิตที่มีในตอนนี้แทบทั้งหมดถูกจัดสรรไว้สำหรับรันงานภายในของ ChatGPT และ Codex ก่อน ยังไม่มีการเปิด API หรือบริการเช่าใช้ Jalapeño ให้ลูกค้าภายนอก และ OpenAI ก็ยังไม่ได้ประกาศเงื่อนไขการขายชิปหรือให้ผู้ให้บริการคลาวด์รายอื่นนำไปใช้งาน
ที่น่าสังเกตคือ Jalapeño ไม่ได้มาแทนที่ชิปจากพันธมิตรฮาร์ดแวร์เดิมของ OpenAI อย่าง Nvidia หรือ AMD แต่ทำงานควบคู่กันไป โดยแผนขยายกำลังการผลิตในดีล 10 กิกะวัตต์กับ Broadcom วางไว้ให้เริ่มติดตั้งแร็กชุดแรกช่วงครึ่งหลังของปี 2026 และเข้าสู่การผลิตระดับปริมาณมากในปี 2027 ส่วนแหล่งหน่วยความจำ HBM4 มีรายงานว่า Samsung เป็นผู้จัดหาให้ แต่ยังไม่ได้รับการยืนยันอย่างเป็นทางการจากทั้งสองบริษัท
สรุป: Jalapeño คือก้าวแรกของ OpenAI ในธุรกิจฮาร์ดแวร์
Jalapeño แสดงให้เห็นว่า OpenAI จริงจังกับการควบคุมต้นทุนและประสิทธิภาพของโครงสร้างพื้นฐานตัวเองมากขึ้น ไม่ใช่แค่พึ่งพาชิปจากผู้ผลิตรายอื่นอย่างเดียวอีกต่อไป ตัวเลขประสิทธิภาพที่เปิดเผยในงาน Hot Chips 2026 ดูน่าสนใจ แต่ทั้งหมดยังเป็นตัวเลขฝั่ง OpenAI เอง และยังไม่มีการเปิดให้ใช้งานนอกบริษัท
ถ้าเป็นผม ผมมองว่า Jalapeño ตอนนี้ยังเป็นเรื่องของโครงสร้างพื้นฐานหลังบ้านล้วน ๆ ยังเร็วเกินไปที่จะคาดหวังว่าจะกลายเป็นสินค้าสำหรับนักพัฒนาทั่วไปในเร็ว ๆ นี้ครับ สิ่งที่น่าติดตามต่อคือช่วงครึ่งหลังปี 2026 ที่แร็กชุดแรกจะเริ่มติดตั้งจริง และจะมีตัวเลขจากการใช้งานจริงมายืนยันคำกล่าวอ้างเรื่องประสิทธิภาพหรือไม่